FFmpeg의 무음 표시는 소리가 전혀 없다는 판정이 아닙니다. 정해 둔 크기보다 작은 신호가 일정 시간 이어졌다는 뜻입니다. AI 내레이션의 자막을 자르거나 입 모양과 소리의 시작을 맞출 때, 무음 종료 시각을 곧바로 실제 발화 시작으로 쓰면 작은 소리를 놓칠 수 있습니다.
이 차이를 확인하려고 직접 만든 7초 파일 하나에 세 가지 기준을 적용했습니다. 파일과 최소 무음 길이는 그대로 두고 noise만 바꿨습니다. 결과는 아래와 같습니다. 실제 사람의 목소리나 청취 시험은 아니며, 도구의 판정 범위를 보여 주는 합성 실험입니다.
직접 확인한 결과: 같은 파일에서 첫 무음 종료가 달라졌습니다
| noise 기준 | 첫 silence_start | 첫 silence_end | 1–3초의 작은 톤 |
|---|---|---|---|
| -45 dBFS | 0초 | 1.000104초 | 무음 구간으로 묶이지 않음 |
| -35 dBFS | 0초 | 4.000042초 | 앞뒤 무음과 함께 묶임 |
| -25 dBFS | 0초 | 4.000104초 | 앞뒤 무음과 함께 묶임 |
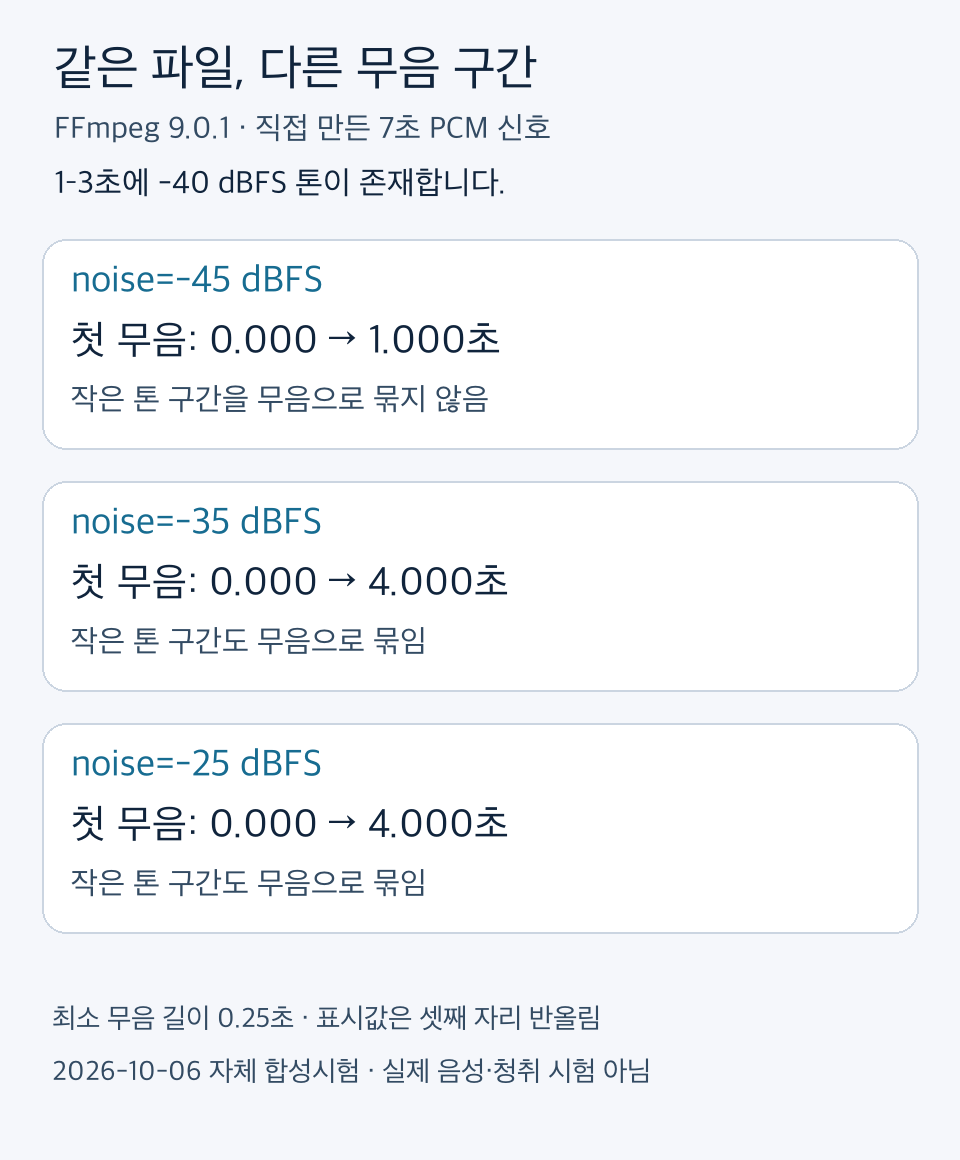
-45dB 기준에서는 1초 뒤의 작은 톤이 무음 종료를 만들었습니다. 반면 -35dB와 -25dB 기준에서는 그 톤까지 무음으로 묶여, 더 큰 톤이 나오는 약 4초에서야 첫 무음이 끝났습니다. 아주 작은 시각 차이는 샘플 단위의 검출 경계이며, 말소리의 음소 시작을 측정한 값이 아닙니다.
어떤 파일로 어떻게 확인했나요?
2026년 10월 6일 FFmpeg 9.0.1에서 실행했습니다. 입력은 48,000Hz·모노·16비트 PCM WAV이며 길이는 7초입니다. 0–1초는 디지털 0, 1–3초는 피크 설계값 -40dBFS의 1,000Hz 톤, 3–4초는 디지털 0, 4–6초는 -20dBFS의 같은 톤, 6–7초는 디지털 0으로 만들었습니다. dBFS는 여기서 디지털 최대값에 대한 크기이며, 전체 평균 소리 크기인 LUFS와 다릅니다.
세 번 모두 최소 무음 길이 d=0.25를 사용했고 명령은 정상 종료했습니다. 이 실험에는 유료 생성 도구나 고객 녹음을 사용하지 않았습니다. 같은 합성 신호에 설정 세 개를 적용한 것이므로, 여러 화자나 마이크를 반복 비교한 성능 평가로 확대할 수 없습니다.
같은 신호 구성의 7초 합성 파일 만들기
위 표와 같은 신호 구성을 다시 만드는 명령입니다. 1–3초는 피크 0.01(-40dBFS), 4–6초는 피크 0.1(-20dBFS)의 1,000Hz 톤이고 나머지는 디지털 0입니다. 새 빈 폴더에서 실행하세요.
ffmpeg -hide_banner -loglevel error -f lavfi -i "aevalsrc='(between(t,1,3)*0.01+between(t,4,6)*0.1)*sin(2*PI*1000*t)':s=48000:d=7" -ac 1 -c:a pcm_s16le test7.wav
for n in -45 -35 -25; do echo "== noise=${n}dB"; ffmpeg -hide_banner -nostats -i test7.wav -af "silencedetect=noise=${n}dB:d=0.25" -f null - 2>&1 | grep -E "silence_(start|end)" | head -2; done
2026년 10월 13일 FFmpeg 9.0.1(macOS)에서 이 명령을 실행하면 첫 silence_start는 모두 0이고 첫 silence_end가 -45dB 기준 1.000104초, -35dB 기준 4.000042초, -25dB 기준 4.000104초로 위 표와 같았습니다. 이 명령으로 만든 파일을 ffprobe로 보면 48,000Hz·모노·16비트 PCM·7.000000초였습니다.
내 파일에서도 기준만 바꿔 확인하는 방법
아래의 MY_AUDIO.wav를 내 파일 이름으로 바꿉니다. 파일 이름에 공백이 있으면 따옴표를 유지하세요. 영상의 오디오 트랙을 검사하려면 입력 파일 이름을 영상 파일로 바꿔도 됩니다. 이 명령은 측정 출력을 만들며 원본을 덮어쓰지 않습니다.
ffmpeg -hide_banner -nostats -i "MY_AUDIO.wav" -af "silencedetect=noise=-45dB:d=0.25" -f null -
ffmpeg -hide_banner -nostats -i "MY_AUDIO.wav" -af "silencedetect=noise=-35dB:d=0.25" -f null -
ffmpeg -hide_banner -nostats -i "MY_AUDIO.wav" -af "silencedetect=noise=-25dB:d=0.25" -f null -
출력의 silence_start, silence_end, silence_duration을 각각 적습니다. 다른 기준에서 경계가 크게 움직였다면 그 부분을 파형과 실제 재생으로 확인하세요. 영상이라면 오디오뿐 아니라 해당 화면도 함께 확인해야 합니다.
자막이나 립싱크를 수정하기 전에
- 현재 설정과 다른 설정의 경계를 같은 파일에서 비교합니다. 파일 버전도 같이 적어야 합니다.
- 검출 경계 주변을 재생해 작은 말소리, 숨소리, 배경음악이나 잡음인지 확인합니다. 이 글의 톤 결과만으로 내 녹음의 내용이나 청취 가능성을 단정하지 않습니다.
- 실제 발화와 화면의 대응을 확인한 뒤에 자막을 자르거나 시차를 조정합니다. 대응 지점이 불분명하면 자동 수정 대신 보류합니다.
- 다시 내보냈다면 새 파일을 재검사하고 끝까지 확인합니다. 도구가 정상 종료한 것과 결과물이 적절한 것은 별도로 기록합니다.
음악이 계속 깔린 파일에서는 조용한 발화 앞뒤가 하나의 구간으로 이어질 수 있고, 아주 낮은 기준에서는 미세한 잡음도 무음 종료를 만들 수 있습니다. 무조건 -45dB를 고르면 된다는 결론도 아닙니다. 파일의 목적과 신호를 보고 기준을 정하고, 그 기준이 어떤 내용을 놓치는지 확인하는 것이 이번 비교의 핵심입니다.
같은 문제를 이어서 확인하기
필터의 기준과 출력 항목은 FFmpeg 공식 silencedetect 문서를 참고했습니다. 이 글의 수치는 위 조건에서 직접 실행한 출력이며, 플랫폼 승인 조건이나 음성 품질 순위를 뜻하지 않습니다.